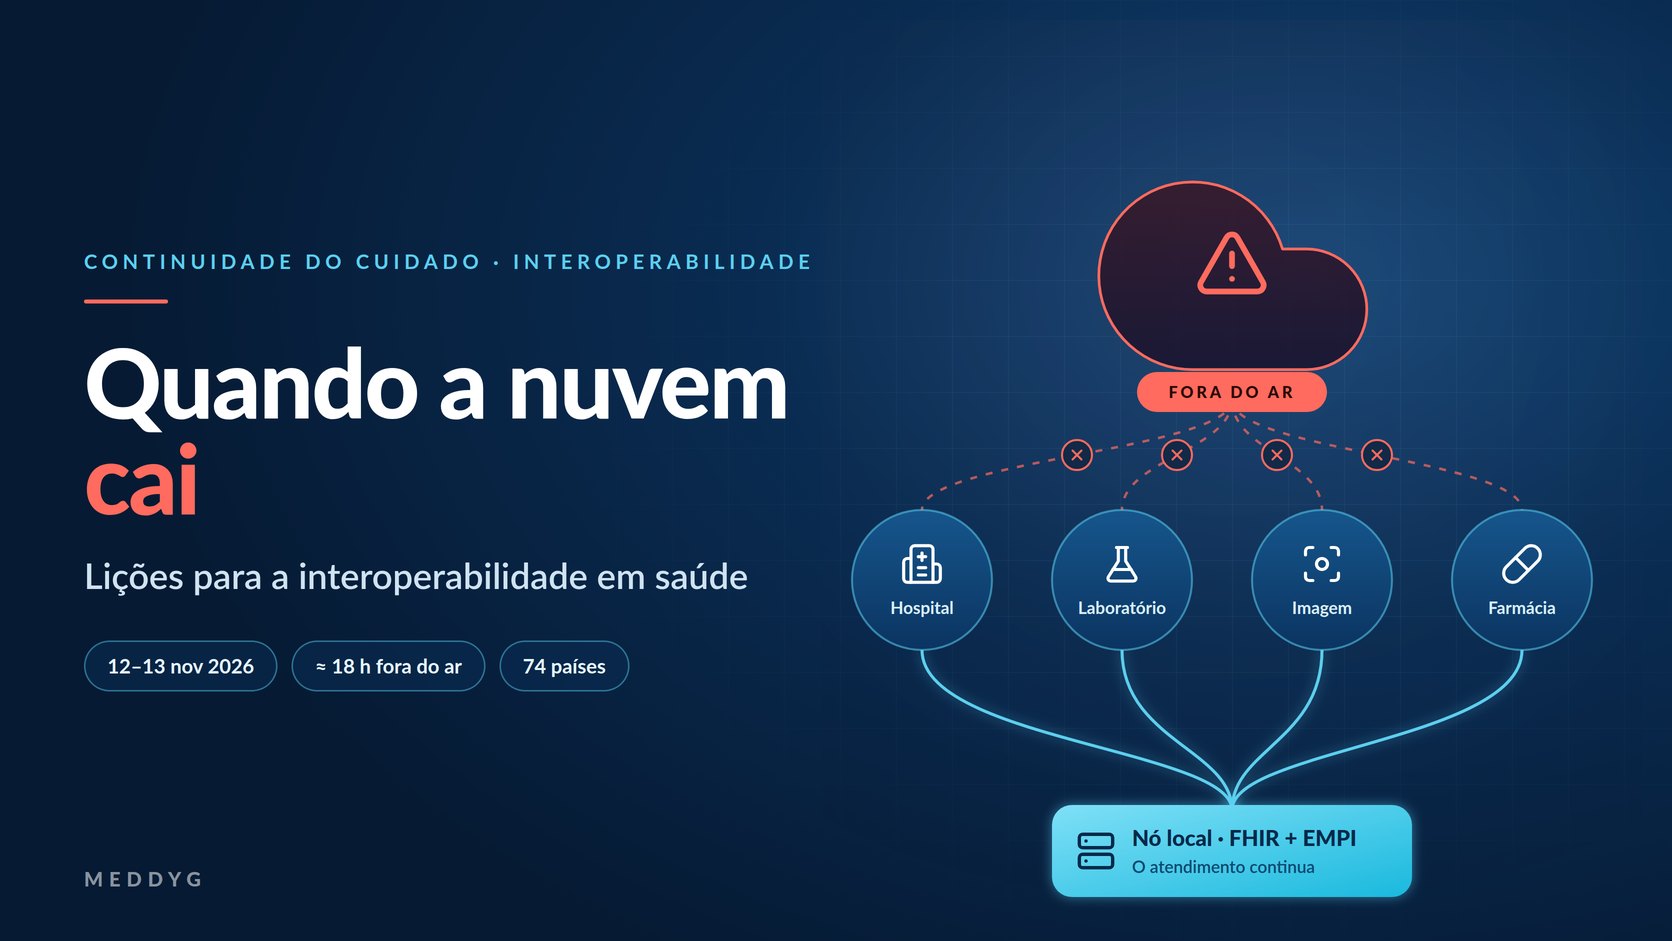
A queda global da Microsoft em 12 e 13 de novembro de 2026 deixou milhões de organizações sem e-mail, colaboração e ferramentas de administração por cerca de 18 horas. Para o setor de saúde, a lição é direta: se a continuidade do cuidado depende de um único fornecedor, ou pior, de uma caixa de e-mail, o atendimento para quando esse fornecedor para.
Este artigo resume o que aconteceu, como um evento assim afeta as plataformas de interoperabilidade, por que o e-mail não é um canal válido para compartilhar informação clínica e quais estratégias de contingência convém ter prontas antes do próximo incidente.
O que aconteceu
Na quinta-feira, 12 de novembro, por volta das 17h30 UTC (11h30 no horário da Costa Rica), usuários do mundo todo deixaram de acessar o Outlook. A Al Jazeera contabilizou impactos em 74 países e territórios. O que começou como uma falha de e-mail e do Teams se transformou em uma crise de nuvem: foram afetados o e-mail de consumidores e empresas, os arquivos e documentos na nuvem, o Copilot, o Defender, os consoles de administração do Intune e alguns computadores Windows hospedados na nuvem, segundo o TechCrunch.
| Dado | Detalhe |
|---|---|
| Início | Quinta-feira, 12/11/2026, por volta das 17h30 UTC (11h30 no horário da Costa Rica) |
| Duração | Cerca de 18 horas até o tráfego começar a voltar, segundo Doug Madory, da Kentik |
| Alcance | 74 países e territórios. A Microsoft não confirmou quantos usuários foram afetados |
| Serviços | Outlook, Teams, Copilot, arquivos e documentos na nuvem, Defender, Intune e computadores Windows na nuvem |
| Causa | Sem relatório de causa raiz. A Microsoft falou primeiro em uma atualização de rede e depois em um grande número de servidores que ficaram indisponíveis e sobrecarregaram os demais |
| Ataque cibernético | A Microsoft afirma que não há evidência de atividade maliciosa |
| Impacto econômico estimado | Até USD 7 bilhões em produtividade perdida, segundo o Anderson Economic Group, citado pela CNN |
Não é um caso isolado. O Microsoft 365 já havia sofrido quedas relevantes neste ano: a de 22 e 23 de janeiro, de cerca de 10 horas na América do Norte (The Register), e a do fim de agosto e início de setembro, que se estendeu por vários dias e que a Microsoft atribuiu a um problema na «configuração central de autenticação» (TechCrunch).
Como isso afeta as plataformas de interoperabilidade
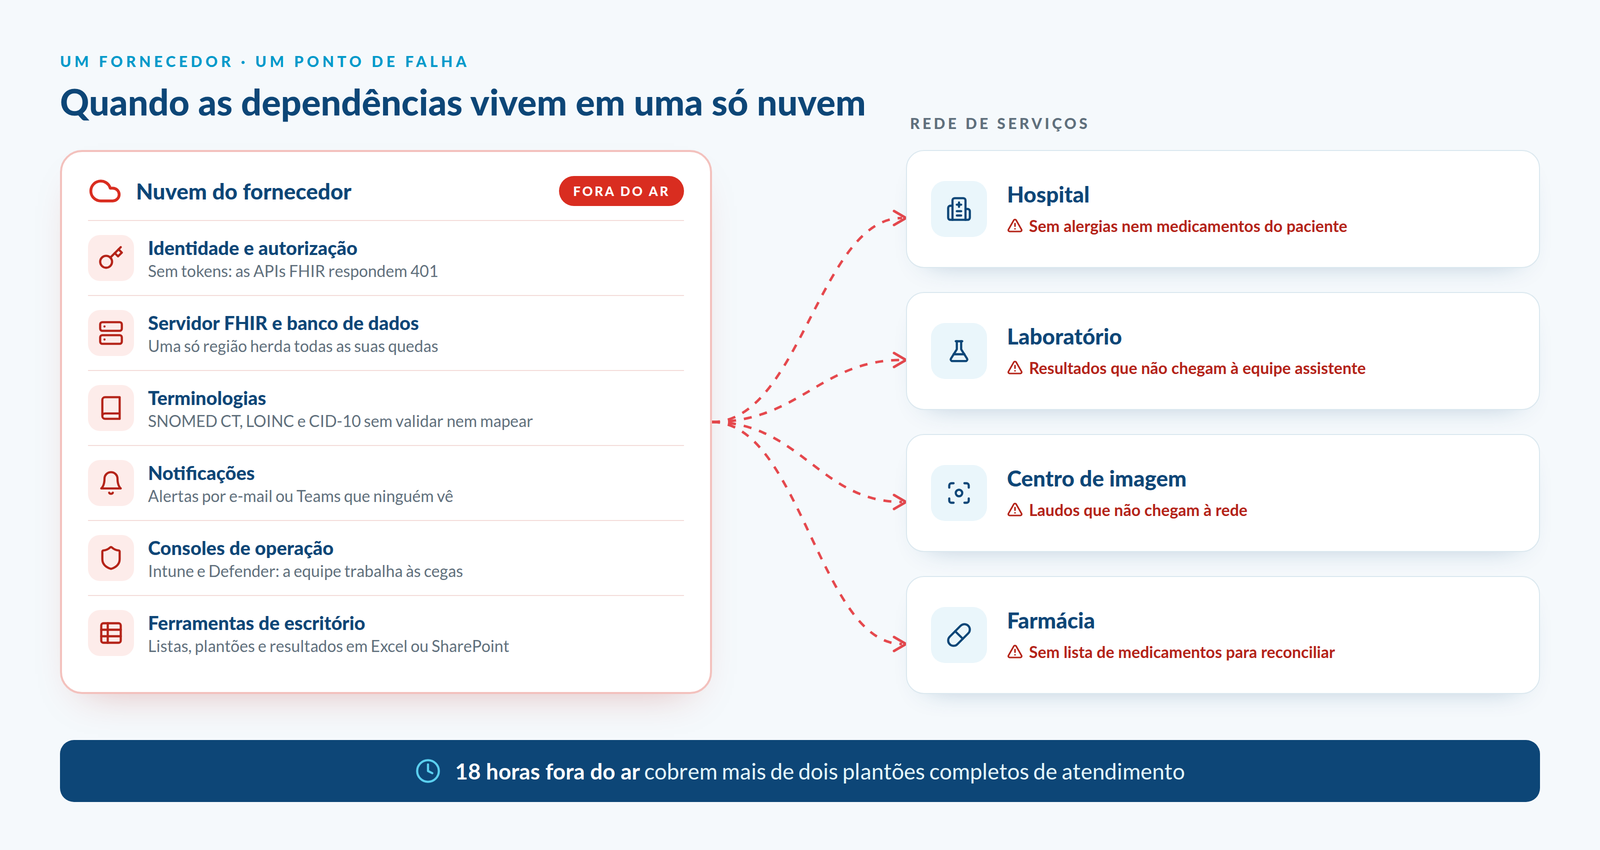
Uma plataforma de interoperabilidade (HIE, servidor FHIR, índice mestre de pacientes ou EMPI, localizador de registros ou RLS) pode ficar fora do ar mesmo com seus próprios servidores funcionando, se alguma de suas dependências críticas estiver no fornecedor afetado. Os pontos de falha mais frequentes são estes:
- Identidade e autorização. Se o servidor de autorização OAuth 2.0 / OpenID Connect, o SMART on FHIR ou o diretório de usuários depende do Microsoft Entra ID e ele falha, nenhum sistema obtém tokens e todas as chamadas FHIR retornam
401, mesmo com o servidor FHIR no ar. A queda de setembro, ligada à autenticação, mostrou esse padrão. - Infraestrutura hospedada em uma única nuvem. Um servidor FHIR, um banco de dados ou um barramento de mensagens implantado em uma única região ou com um único fornecedor herda todas as suas quedas, incluindo as de DNS e de rede.
- Serviços de suporte compartilhados. Terminologias (SNOMED CT, LOINC, CID-10) servidas a partir de um único endpoint, gerenciadores de chaves e certificados, assinatura digital, filas e monitoramento. Se o servidor de terminologia falha, também falham a validação de recursos e o mapeamento de códigos.
- Notificações e fluxos de trabalho. Assinaturas FHIR, alertas de resultados críticos ou encaminhamentos notificados por e-mail ou Teams se perdem em silêncio: o dado chega, mas ninguém fica sabendo.
- Operação e segurança. Sem os consoles de administração (Intune, Defender), a equipe técnica não consegue ver, isolar nem recuperar equipamentos; trabalha às cegas justamente quando mais precisa de visibilidade.
- Processos paralelos em ferramentas de escritório. Listas de pacientes, escalas de plantão, resultados em Excel ou SharePoint e reuniões de coordenação clínica deixam de estar disponíveis.
O efeito clínico é a perda do contexto do paciente no ponto de atendimento: alergias, medicamentos, resultados recentes e encaminhamentos pendentes. Em uma rede de serviços, uma queda de 18 horas cobre mais de dois plantões completos.
Por que o e-mail não serve para a continuidade do cuidado
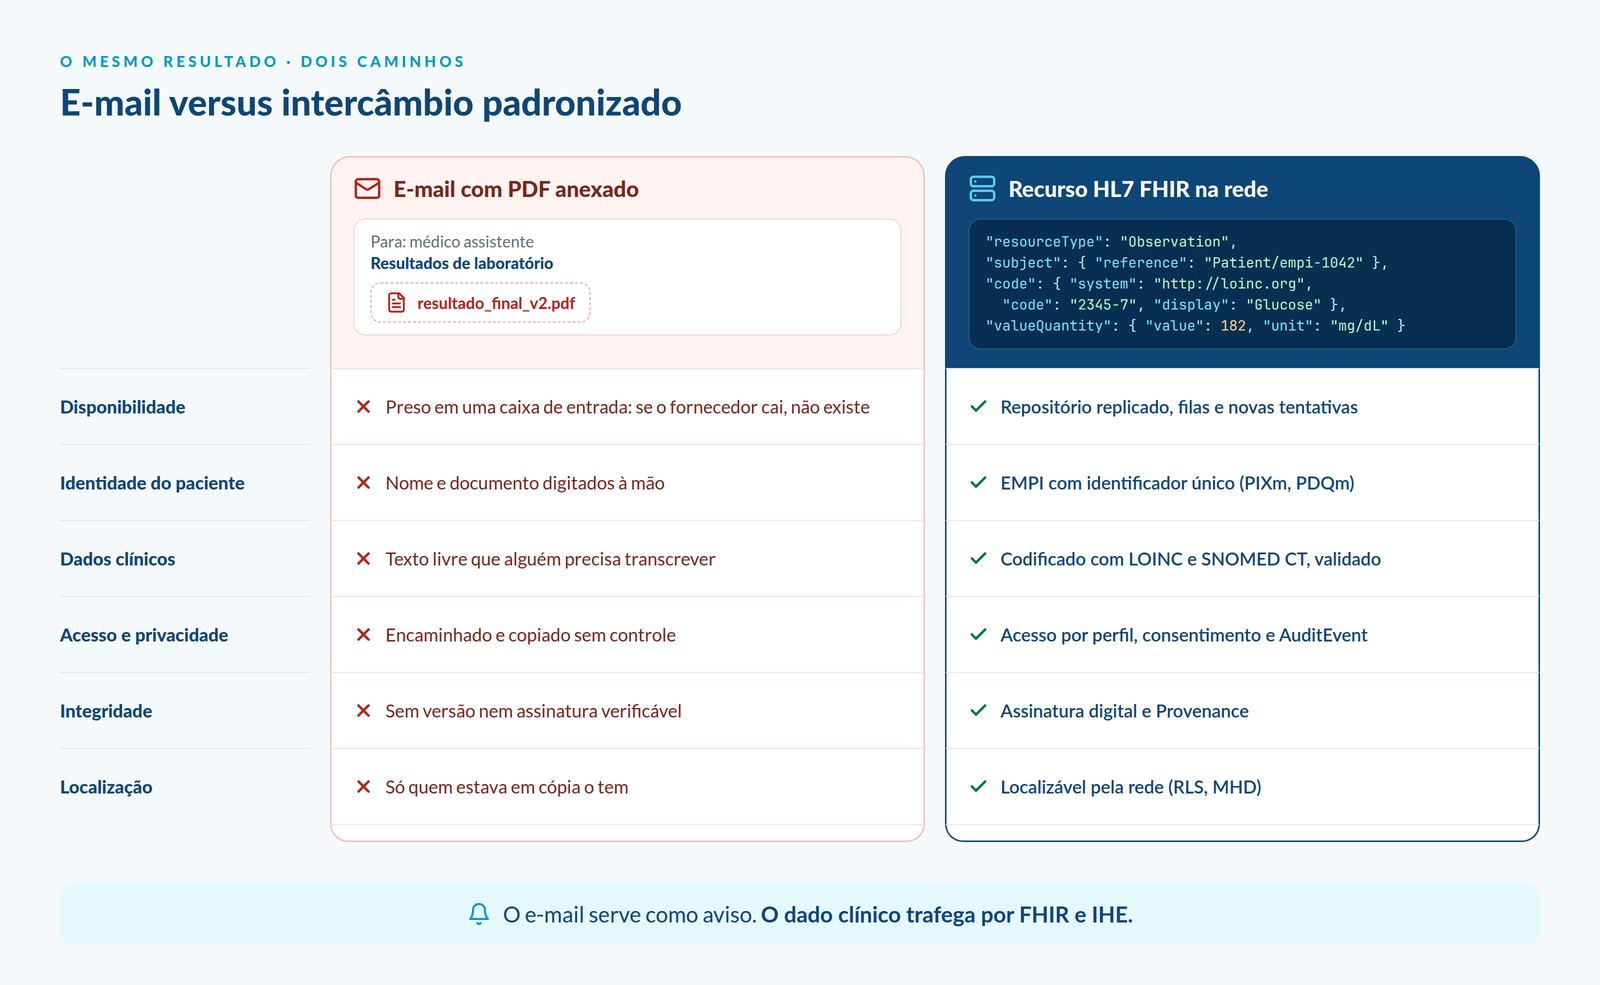
O e-mail é um canal de comunicação entre pessoas, não um mecanismo de troca de dados clínicos. Esta queda deixou isso evidente: as organizações que enviavam resumos de alta, resultados ou encaminhamentos pelo Outlook não tiveram acesso a essa informação enquanto durou a falha. A Microsoft ampliou para 48 horas o prazo de nova tentativa para preservar as mensagens atrasadas, mas preservá-las não é o mesmo que tê-las disponíveis quando a equipe assistencial precisa. As razões de fundo são estas:
- Disponibilidade. O dado fica preso em uma caixa de e-mail. Se o fornecedor cai, o dado não existe para a equipe assistencial: não há uma rota alternativa para consultá-lo.
- Dados não estruturados. Um PDF de resultados de laboratório ou um laudo de imagem em texto livre não se integra ao prontuário, não é validado contra um perfil FHIR e não usa terminologias como SNOMED CT ou LOINC. Não alimenta alertas de alergias nem de interações, e alguém precisa transcrevê-lo, com o risco de erro que isso implica.
- Identificação do paciente. Não há EMPI nem identificador único: o anexo depende de que quem envia e quem recebe escrevam corretamente o nome e o número do documento de identidade. Um erro de identidade aqui é um risco para a segurança do paciente.
- Segurança e privacidade. Um e-mail é reencaminhado, baixado em dispositivos pessoais e fica em múltiplas cópias. Não há controle de acesso por perfil, gestão do consentimento nem registro (
AuditEvent) de quem viu o quê, algo difícil de conciliar com a Lei 8968 da Costa Rica, de proteção de dados pessoais, e com o Regulamento de Interoperabilidade em Saúde. - Rastreabilidade e integridade. Não há confirmação clínica de recebimento, versão, assinatura verificável nem proveniência (
Provenance). Não é possível demonstrar qual versão de um resultado foi usada para decidir. - Localização. Nenhum outro prestador consegue descobrir que esse documento existe. Sem um RLS ou um índice de documentos, a informação fica só com quem estava em cópia.
- Concentração do risco. E-mail, chat, arquivos e identidade costumam estar com o mesmo fornecedor. Uma única queda derruba o canal principal e o de backup ao mesmo tempo.
O e-mail pode ser usado como aviso («há um novo resultado disponível»), mas o dado clínico deve trafegar por canais padronizados (HL7 FHIR REST e perfis IHE como MHD, XDS, PIXm ou PDQm) até repositórios com identidade, consentimento e auditoria.
Estratégias de contingência
A meta não é evitar toda queda, mas fazer com que o atendimento continue quando ela ocorrer. Convém trabalhar em quatro frentes ao mesmo tempo.
Arquitetura
- Desacoplar a identidade. Um servidor de autorização próprio da rede (OpenID Connect, SMART on FHIR) que se federe com o Entra ID ou outros provedores de identidade, mas que não dependa deles para emitir tokens. Assim, uma queda do provedor de identidade corporativo não bloqueia as APIs FHIR.
- Redundância real. Implantação multirregião ou multinuvem, ou um modelo híbrido com um nó local do servidor FHIR e do EMPI, com replicação. A queda de um fornecedor não deve derrubar o intercâmbio.
- Cache no ponto de atendimento. Um Resumo Internacional do Paciente (IPS) ou um resumo clínico mínimo dos pacientes ativos, atualizado periodicamente, para contar com alergias, medicamentos e problemas mesmo sem rede.
- Mensageria assíncrona. Filas persistentes com novas tentativas (*store-and-forward*) e idempotência nas transações FHIR, para que nada se perca e tudo seja conciliado quando o serviço voltar.
- Terminologia replicada. Um servidor de terminologia replicado e pacotes de terminologia locais, para validar e codificar sem depender de um endpoint externo.
Operação
- Canais de aviso fora de banda. SMS, mensageria com outro fornecedor, telefonia e páginas de status hospedadas fora da nuvem principal, para avisar clínicos e técnicos quando o canal habitual cai.
- **Contas de emergência (*break-glass*).** Acesso administrativo que não dependa da mesma nuvem, para operar e recuperar mesmo com os consoles fora do ar.
- Monitoramento sintético e simulações. Monitorar os fluxos clínicos de ponta a ponta, não só os servidores, e praticar o plano com regularidade.
Governança
- Mapa de dependências e análise de impacto nos negócios (BIA). Objetivos de tempo e ponto de recuperação (RTO/RPO) por fluxo clínico e um plano de continuidade alinhado à ISO 22301: saber o que cai com qual fornecedor e quanto se tolera.
- Contratos. SLA com compensações, relatórios de causa raiz e cláusulas de saída e portabilidade de dados, para reduzir a dependência de um único fornecedor.
- Política institucional. Aplicar o Regulamento de Interoperabilidade em Saúde e os Guias Nacionais de Implementação, e deixar por escrito que o e-mail não é um canal para dados clínicos.
Clínica
- Procedimentos de contingência. Formulários em papel ou offline para encaminhamentos, pedidos e resultados; os resultados críticos são comunicados por telefone com leitura de confirmação.
- Conciliação posterior. Registrar no sistema o que foi anotado durante a contingência, com sua proveniência, para que o prontuário fique completo e rastreável.
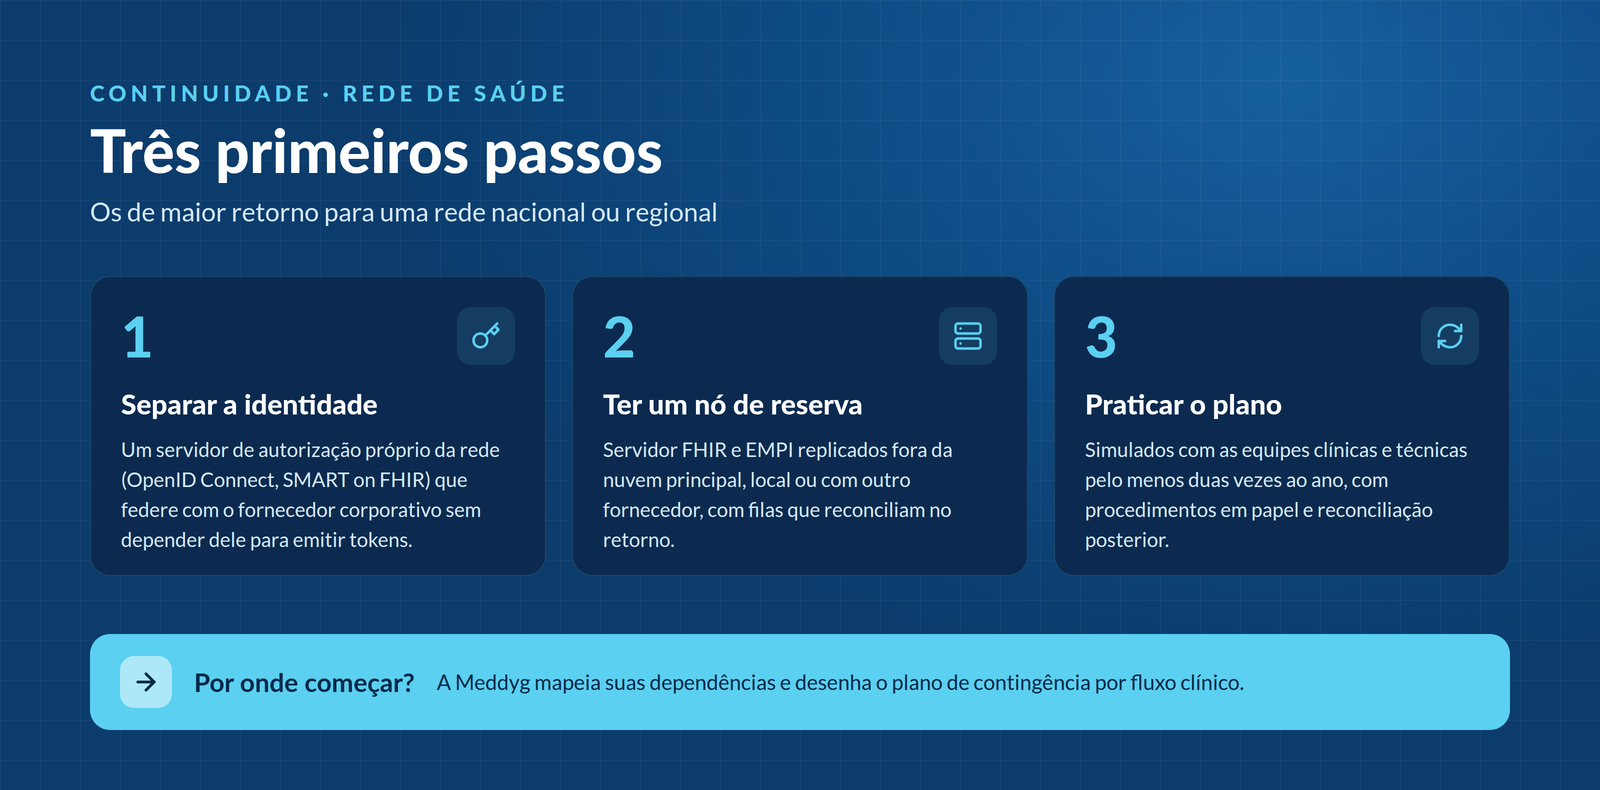
Para uma rede nacional ou regional, os três primeiros passos com maior retorno são separar a identidade do fornecedor de ferramentas de escritório, ter um nó de backup do servidor FHIR e do EMPI fora da nuvem principal e praticar o plano de contingência com as equipes clínicas pelo menos duas vezes por ano.
Conclusão
A queda da Microsoft não foi um problema de saúde, mas expôs um risco de saúde: quando a informação clínica depende de uma caixa de e-mail ou de um único fornecedor, a continuidade do cuidado depende da disponibilidade dele. A interoperabilidade baseada em padrões (HL7 FHIR, IHE e terminologias comuns) não só permite compartilhar dados; também permite projetar redes que resistem a falhas, com identidade própria, redundância, filas e procedimentos clínicos de contingência.
Com o PRIS+ em andamento, a Costa Rica está definindo como suas instituições vão se conectar. É o momento de a resiliência fazer parte desse desenho desde o início.
A pergunta para cada instituição e para cada rede de serviços é concreta: se amanhã o fornecedor principal cair por 18 horas, que informação clínica continua disponível no ponto de atendimento e como se recupera o que for registrado nesse meio-tempo? Respondê-la antes do próximo incidente faz parte da qualidade e da segurança do paciente.
Como a Meddyg pode ajudar
Na Meddyg, ajudamos instituições de saúde, laboratórios e centros de imagem a deixar o e-mail como canal de dados clínicos e a construir uma interoperabilidade que continue funcionando quando um fornecedor falha. Trabalhamos com HL7 FHIR, perfis IHE, OpenHIE e terminologias como SNOMED CT, LOINC e CID-10, alinhados aos guias de implementação nacionais da Costa Rica.
- Diagnóstico de continuidade. Levantamos o mapa de dependências dos seus fluxos clínicos (identidade, e-mail, nuvem, terminologias), identificamos os pontos únicos de falha e propomos um plano de contingência com objetivos de recuperação por fluxo. Faz parte da nossa avaliação de interoperabilidade.
- Resultados de laboratório sem e-mail. Convertemos o laudo de laboratório em um documento FHIR estruturado, codificado com LOINC e assinado digitalmente com a assinatura digital nacional da Costa Rica (Firma Digital de Costa Rica) por meio do Kivú eSignature antes de ser armazenado. O resultado chega ao prontuário e à equipe assistencial com integridade verificável, em vez de um PDF anexo que alguém precisa transcrever. Também mapeamos catálogos de exames para LOINC com o Kivú Terminology.
- Laudos de imagens médicas interoperáveis. Participamos da construção do guia HL7 FHIR de laudos de imagens médicas para a Costa Rica e oferecemos o Kivú RIS e o Kivú PACS, que integram DICOM e FHIR para que o exame e seu laudo estejam disponíveis para a rede de atendimento, e não em um e-mail ou em um disco.
- Plataforma de intercâmbio resiliente. Nossa plataforma de intercâmbio de informação em saúde, construída sobre o Kivú FHIR, inclui servidor FHIR, índice mestre de pacientes (EMPI com PIXm, PDQm e PMIR), localizador de registros (RLS) e um servidor de autorização próprio da comunidade (OAuth 2.0 / OpenID Connect, IHE IUA) que não depende do fornecedor de ferramentas de escritório para conceder acessos. Pode ser implantada na nuvem, no local ou em modelo híbrido. Veja nosso serviço de integração HIE.
- Auditoria, consentimento e proveniência. Cada acesso e cada documento ficam registrados com
AuditEventeProvenance, com gestão do consentimento do paciente. - Acompanhamento e simulações. Capacitamos as equipes técnicas e clínicas e as ajudamos a praticar o plano de contingência.
Se a sua instituição compartilha hoje resultados, laudos ou encaminhamentos por e-mail, vamos conversar. Escreva para nós e vemos juntos por onde começar.
Fontes
- TechCrunch, Microsoft's latest email outage turned into a full blown global cloud crisis, 13/11/2026.
- Al Jazeera, Microsoft hit by global outages: What happened and why?, 13/11/2026.
- CNN, Massive Microsoft outage disrupts businesses, schools and governments around the world, 12/11/2026.
- Security Magazine, Microsoft Outage Could Lead to $7B in Losses, estimativa do Anderson Economic Group.
- The Irish Times, Microsoft outage: what happened and what does it say about online services?, 13/11/2026.
- TechCrunch, Microsoft 365 outage drags on, but things are improving, 01/09/2026.
- The Register, Microsoft 365 outage drags on for nearly 10 hours, 23/01/2026.
Boletim da Meddyg
Notícias, novidades de interoperabilidade e saúde digital, e o que há de novo em nossos serviços e produtos.