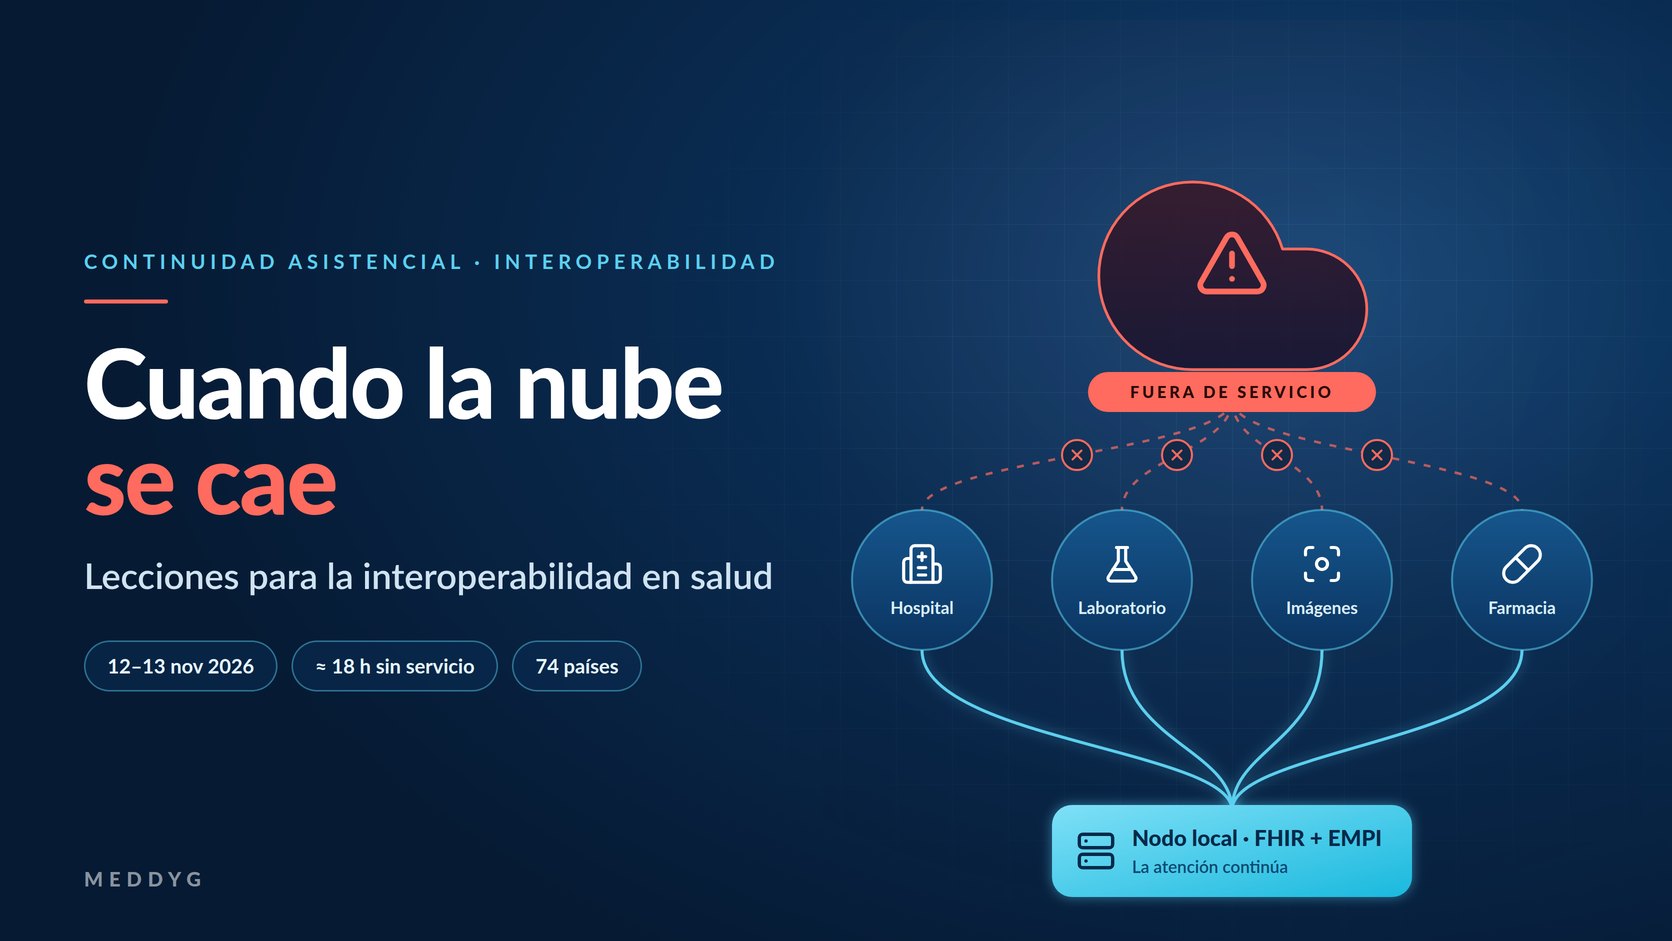
La caída global de Microsoft del 12 y 13 de noviembre de 2026 dejó sin correo, colaboración ni herramientas de administración a millones de organizaciones durante cerca de 18 horas. Para el sector salud la lección es directa: si la continuidad de la atención depende de un solo proveedor, o peor, de un buzón de correo, la atención se detiene cuando ese proveedor se detiene.
Este artículo resume qué pasó, cómo un evento así afecta a las plataformas de interoperabilidad, por qué el correo electrónico no es un canal válido para compartir información clínica y qué estrategias de contingencia conviene tener listas antes del próximo incidente.
Qué pasó
El jueves 12 de noviembre, hacia las 17:30 UTC (11:30 en Costa Rica), usuarios de todo el mundo dejaron de acceder a Outlook. Al Jazeera contabilizó afectaciones en 74 países y territorios. Lo que empezó como una falla de correo y Teams escaló a una crisis de nube: se vieron afectados el correo de consumidores y empresas, los archivos y documentos en la nube, Copilot, Defender, las consolas de administración de Intune y algunos equipos Windows alojados en la nube, según TechCrunch.
| Dato | Detalle |
|---|---|
| Inicio | Jueves 12/11/2026, hacia las 17:30 UTC (11:30 en Costa Rica) |
| Duración | Cerca de 18 horas hasta que el tráfico empezó a regresar, según Doug Madory, de Kentik |
| Alcance | 74 países y territorios. Microsoft no ha confirmado cuántos usuarios se vieron afectados |
| Servicios | Outlook, Teams, Copilot, archivos y documentos en la nube, Defender, Intune y equipos Windows en la nube |
| Causa | Sin informe de causa raíz. Microsoft habló primero de una actualización de red y después de una gran cantidad de servidores que quedaron no disponibles y sobrecargaron al resto |
| Ciberataque | Microsoft afirma que no hay evidencia de actividad maliciosa |
| Impacto económico estimado | Hasta USD 7 000 millones en productividad perdida, según Anderson Economic Group, citada por CNN |
No es un caso aislado. Microsoft 365 ya había tenido caídas relevantes este año: la del 22 y 23 de enero, de cerca de 10 horas en Norteamérica (The Register), y la de finales de agosto e inicios de septiembre, que se extendió por varios días y que Microsoft atribuyó a un problema en la «configuración central de autenticación» (TechCrunch).
Cómo afecta a las plataformas de interoperabilidad
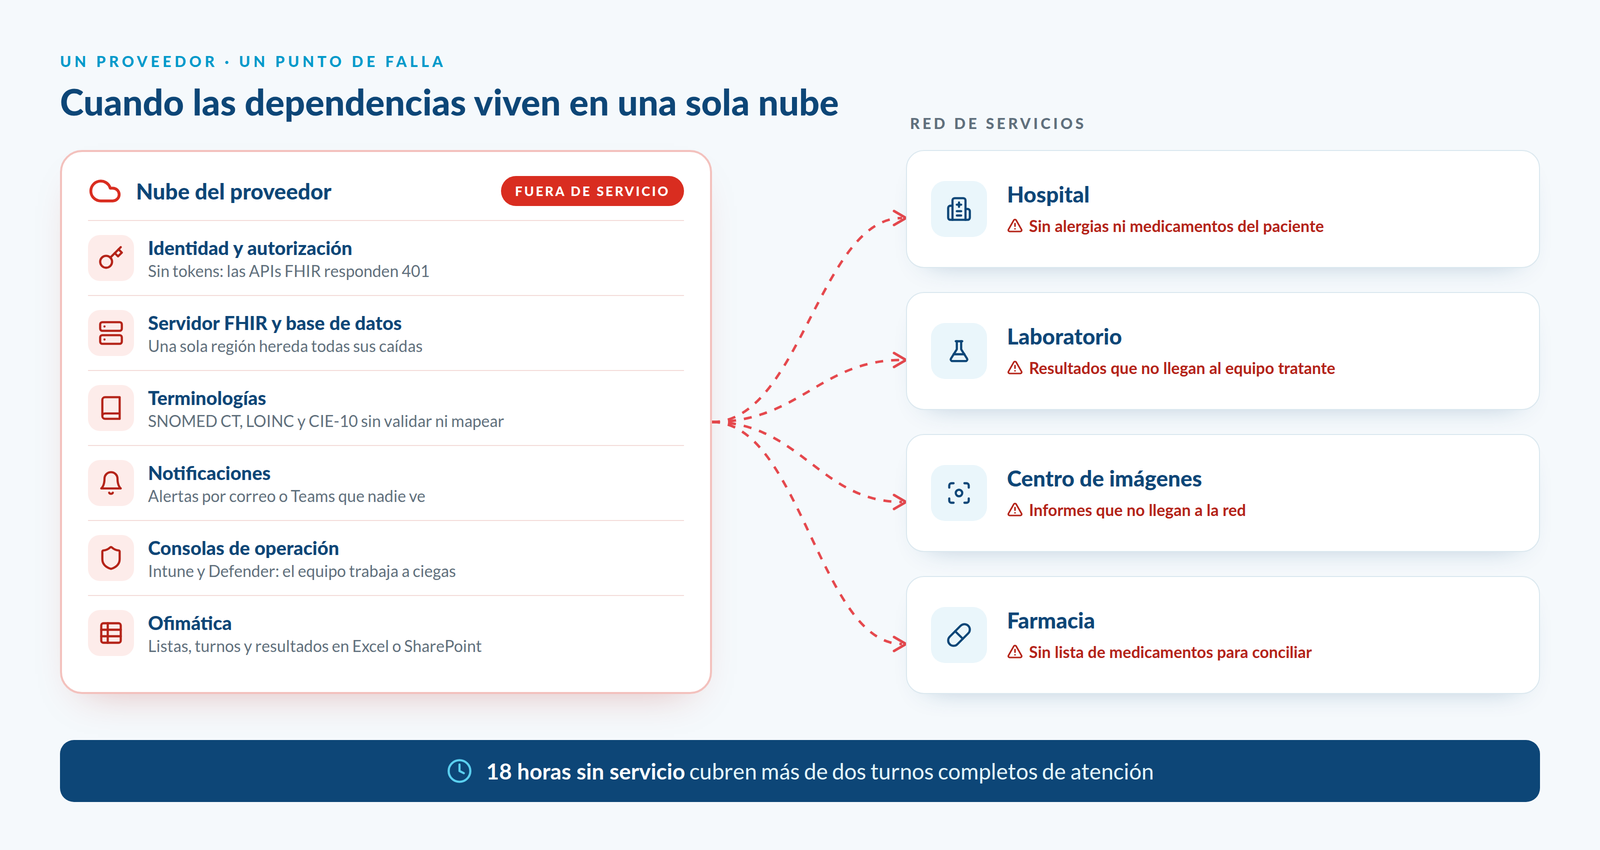
Una plataforma de interoperabilidad (HIE, servidor FHIR, índice maestro de pacientes o EMPI, localizador de registros o RLS) puede quedar fuera de servicio aunque sus propios servidores sigan funcionando, si alguna de sus dependencias críticas vive en el proveedor afectado. Los puntos de falla más frecuentes son estos:
- Identidad y autorización. Si el servidor de autorización OAuth 2.0 / OpenID Connect, SMART on FHIR o el directorio de usuarios depende de Microsoft Entra ID y este falla, ningún sistema obtiene tokens y todas las llamadas FHIR devuelven
401, aunque el servidor FHIR esté arriba. La caída de septiembre, ligada a la autenticación, mostró este patrón. - Infraestructura alojada en una sola nube. Un servidor FHIR, una base de datos o un bus de mensajería desplegado en una única región o con un único proveedor hereda todas sus caídas, incluidas las de DNS y red.
- Servicios de soporte compartidos. Terminologías (SNOMED CT, LOINC, CIE-10) servidas desde un único endpoint, gestores de llaves y certificados, firma digital, colas y monitoreo. Si falla el servidor de terminología, también fallan la validación de recursos y el mapeo de códigos.
- Notificaciones y flujos de trabajo. Suscripciones FHIR, alertas de resultados críticos o referencias que se notifican por correo o Teams se pierden en silencio: el dato llega, pero nadie se entera.
- Operación y seguridad. Sin las consolas de administración (Intune, Defender) el equipo técnico no puede ver, aislar ni recuperar equipos; trabaja a ciegas justo cuando más necesita visibilidad.
- Procesos paralelos sobre ofimática. Listas de pacientes, hojas de turno, resultados en Excel o SharePoint y reuniones de coordinación clínica dejan de estar disponibles.
El efecto clínico es la pérdida del contexto del paciente en el punto de atención: alergias, medicamentos, resultados recientes y referencias pendientes. En una red de servicios, una caída de 18 horas cubre más de dos turnos completos de atención.
Por qué el correo electrónico no sirve para la continuidad asistencial
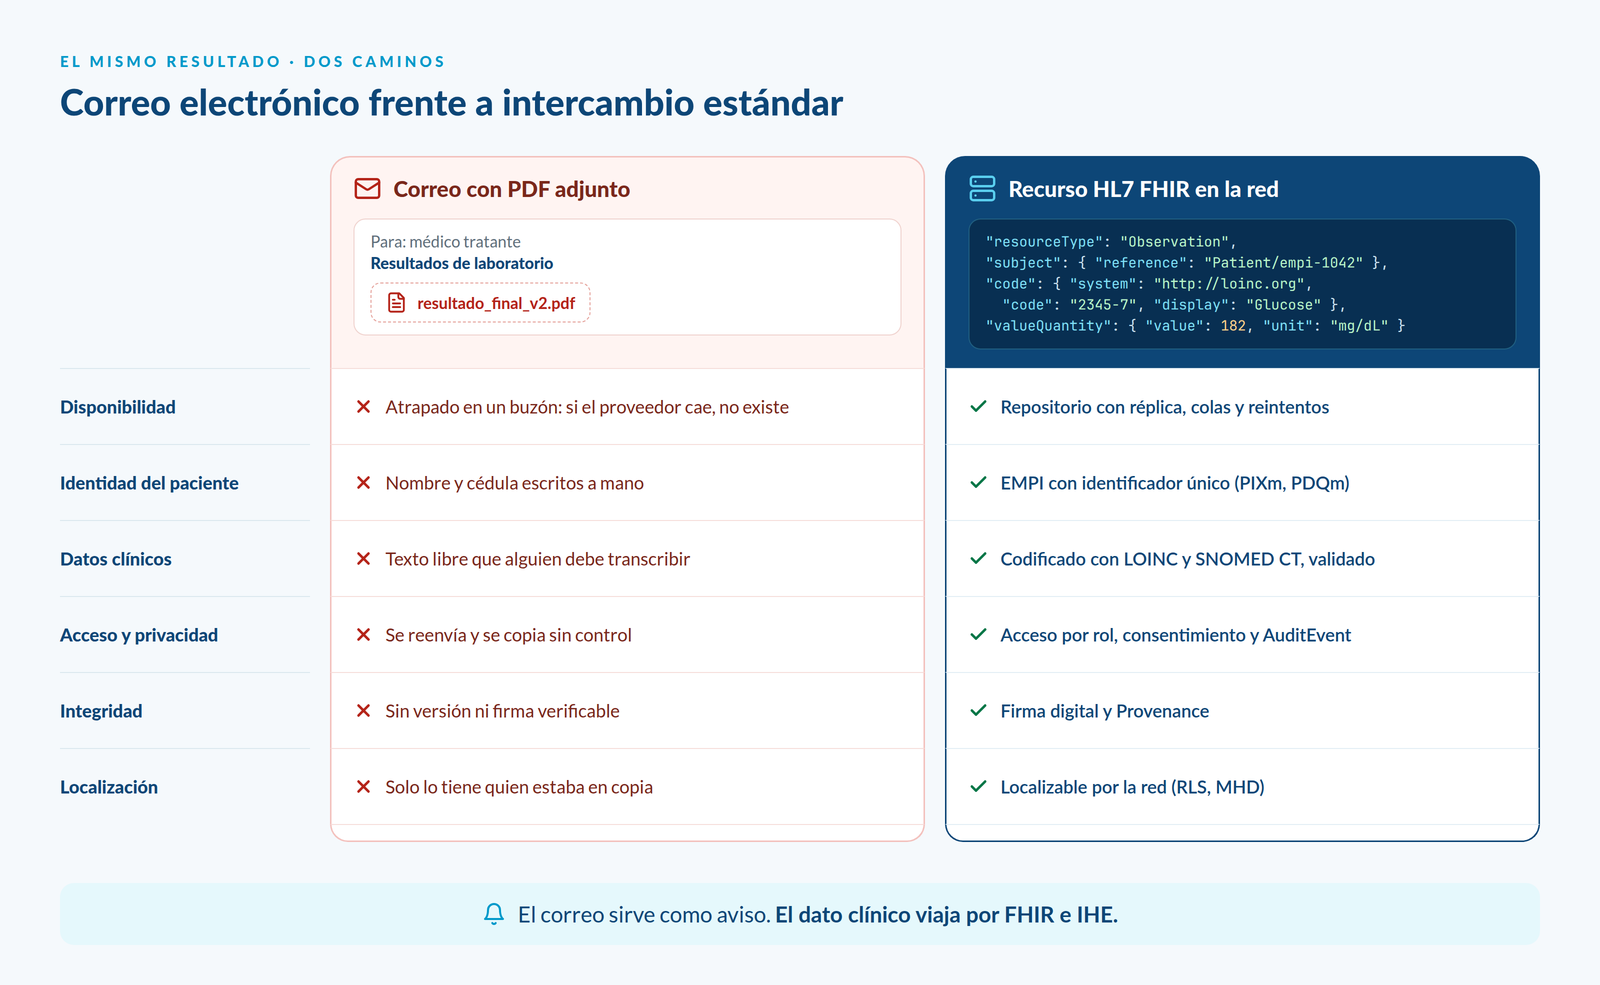
El correo es un canal de comunicación entre personas, no un mecanismo de intercambio de datos clínicos. Esta caída lo dejó en evidencia: las organizaciones que enviaban epicrisis, resultados o referencias por Outlook no tuvieron acceso a esa información mientras duró la falla. Microsoft amplió a 48 horas el plazo de reintento para conservar el correo demorado, pero conservarlo no es lo mismo que tenerlo disponible cuando el equipo tratante lo necesita. Las razones de fondo son estas:
- Disponibilidad. El dato queda atrapado en un buzón. Si el proveedor cae, el dato no existe para el equipo tratante: no hay una ruta alterna para consultarlo.
- Datos no estructurados. Un PDF de resultados de laboratorio o un informe de imágenes en texto libre no se integra al expediente, no se valida contra un perfil FHIR y no usa terminologías como SNOMED CT o LOINC. No alimenta alertas de alergias ni de interacciones, y alguien tiene que transcribirlo, con el riesgo de error que eso implica.
- Identificación del paciente. No hay EMPI ni identificador único: el adjunto depende de que quien envía y quien recibe escriban bien el nombre y la cédula. Un error de identidad aquí es un riesgo para la seguridad del paciente.
- Seguridad y privacidad. Un correo se reenvía, se descarga en dispositivos personales y queda en múltiples copias. No hay control de acceso por rol, gestión del consentimiento ni bitácora (
AuditEvent) de quién vio qué, algo difícil de conciliar con la Ley 8968 de protección de datos personales y con el Reglamento de Interoperabilidad en Salud. - Trazabilidad e integridad. No hay acuse de recibo clínico, versión, firma verificable ni procedencia (
Provenance). No se puede demostrar qué versión de un resultado se usó para decidir. - Localización. Ningún otro prestador puede descubrir que ese documento existe. Sin un RLS o un índice de documentos, la información solo la tiene quien estaba en copia.
- Concentración del riesgo. Correo, chat, archivos e identidad suelen estar con el mismo proveedor. Una sola caída se lleva el canal principal y el de respaldo al mismo tiempo.
El correo puede usarse como aviso («hay un nuevo resultado disponible»), pero el dato clínico debe viajar por canales estándar (HL7 FHIR REST y perfiles IHE como MHD, XDS, PIXm o PDQm) hacia repositorios con identidad, consentimiento y auditoría.
Estrategias de contingencia
La meta no es evitar toda caída, sino que la atención siga cuando ocurra. Conviene trabajar en cuatro frentes a la vez.
Arquitectura
- Desacoplar la identidad. Un servidor de autorización propio de la red (OpenID Connect, SMART on FHIR) que federe con Entra ID u otros proveedores de identidad, pero que no dependa de ellos para emitir tokens. Así, una caída del proveedor de identidad corporativo no bloquea las APIs FHIR.
- Redundancia real. Despliegue multirregión o multinube, o un modelo híbrido con un nodo local del servidor FHIR y del EMPI, con replicación. La caída de un proveedor no debe tumbar el intercambio.
- Caché en el punto de atención. Un Resumen Internacional del Paciente (IPS) o un resumen clínico mínimo de los pacientes activos, actualizado de forma periódica, para contar con alergias, medicamentos y problemas aunque no haya red.
- Mensajería asíncrona. Colas persistentes con reintentos (*store-and-forward*) e idempotencia en las transacciones FHIR, para que nada se pierda y todo se concilie al volver.
- Terminología replicada. Un servidor de terminología replicado y paquetes de terminología locales, para validar y codificar sin depender de un endpoint externo.
Operación
- Canales de aviso fuera de banda. SMS, mensajería con otro proveedor, telefonía y páginas de estado alojadas fuera de la nube principal, para avisar a clínicos y técnicos cuando el canal habitual cae.
- **Cuentas de emergencia (*break-glass*).** Acceso administrativo que no dependa de la misma nube, para operar y recuperar aunque las consolas estén caídas.
- Monitoreo sintético y simulacros. Monitorear los flujos clínicos de punta a punta, no solo los servidores, y practicar el plan con regularidad.
Gobernanza
- Mapa de dependencias y análisis de impacto (BIA). Objetivos de tiempo y punto de recuperación (RTO/RPO) por flujo clínico y un plan de continuidad alineado con ISO 22301: saber qué cae con qué proveedor y cuánto se tolera.
- Contratos. SLA con compensaciones, informes de causa raíz y cláusulas de salida y portabilidad de datos, para reducir la dependencia de un solo proveedor.
- Política institucional. Aplicar el Reglamento de Interoperabilidad en Salud y las Guías Nacionales de Implementación, y dejar por escrito que el correo no es un canal para datos clínicos.
Clínico
- Procedimientos de contingencia. Formularios en papel o fuera de línea para referencias, órdenes y resultados; los resultados críticos se comunican por teléfono con lectura de verificación.
- Conciliación posterior. Cargar en el sistema lo registrado durante la contingencia, con su procedencia, para que el expediente quede completo y trazable.
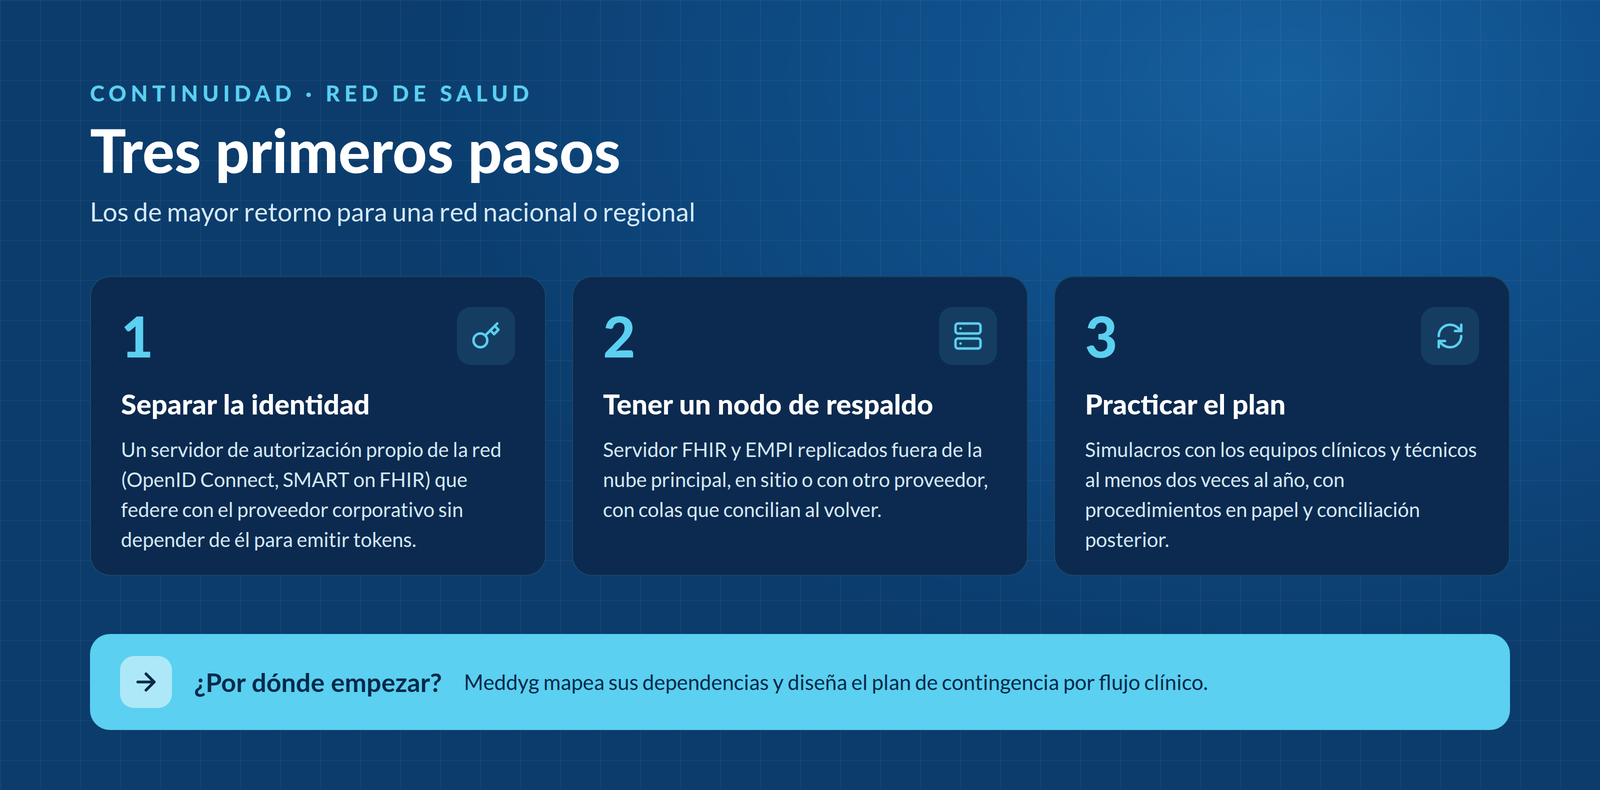
Para una red nacional o regional, los tres primeros pasos con mayor retorno son separar la identidad del proveedor de ofimática, tener un nodo de respaldo del servidor FHIR y del EMPI fuera de la nube principal, y practicar el plan de contingencia con los equipos clínicos al menos dos veces al año.
Conclusión
La caída de Microsoft no fue un problema de salud, pero expuso un riesgo de salud: cuando la información clínica depende de un buzón o de un único proveedor, la continuidad de la atención depende de su disponibilidad. La interoperabilidad basada en estándares (HL7 FHIR, IHE y terminologías comunes) no solo permite compartir datos; también permite diseñar redes que resisten fallas, con identidad propia, redundancia, colas y procedimientos clínicos de respaldo.
Con PRIS+ en marcha, Costa Rica está definiendo cómo se conectarán sus instituciones. Es el momento de que la resiliencia forme parte de ese diseño desde el inicio.
La pregunta para cada institución y para cada red de servicios es concreta: si mañana se cae el proveedor principal durante 18 horas, ¿qué información clínica sigue disponible en el punto de atención y cómo se recupera lo que se registre mientras tanto? Responderla antes del próximo incidente es parte de la calidad y de la seguridad del paciente.
Cómo puede ayudarle Meddyg
En Meddyg acompañamos a instituciones de salud, laboratorios y centros de imágenes a dejar el correo electrónico como canal de datos clínicos y a construir interoperabilidad que siga funcionando cuando un proveedor falla. Trabajamos con HL7 FHIR, perfiles IHE, OpenHIE y terminologías como SNOMED CT, LOINC y CIE-10, alineados con las guías de implementación nacionales de Costa Rica.
- Diagnóstico de continuidad. Levantamos el mapa de dependencias de sus flujos clínicos (identidad, correo, nube, terminologías), identificamos los puntos únicos de falla y proponemos un plan de contingencia con objetivos de recuperación por flujo. Es parte de nuestra evaluación de interoperabilidad.
- Resultados de laboratorio sin correo. Convertimos el reporte de laboratorio en un documento FHIR estructurado, codificado con LOINC y firmado digitalmente con la Firma Digital de Costa Rica mediante Kivú eSignature antes de almacenarse. El resultado llega al expediente y al equipo tratante con integridad verificable, en lugar de un PDF adjunto que alguien debe transcribir. También mapeamos catálogos de exámenes a LOINC con Kivú Terminology.
- Informes de imágenes médicas interoperables. Participamos en la construcción de la guía HL7 FHIR de informes de imágenes médicas para Costa Rica y ofrecemos Kivú RIS y Kivú PACS, que integran DICOM y FHIR para que el estudio y su informe estén disponibles para la red de atención, no en un correo ni en un disco.
- Plataforma de intercambio resiliente. Nuestra plataforma de intercambio de información en salud, construida sobre Kivú FHIR, incluye servidor FHIR, índice maestro de pacientes (EMPI con PIXm, PDQm y PMIR), localizador de registros (RLS) y un servidor de autorización propio de la comunidad (OAuth 2.0 / OpenID Connect, IHE IUA) que no depende del proveedor de ofimática para emitir accesos. Puede desplegarse en la nube, en sitio o en modelo híbrido. Vea nuestro servicio de integración HIE.
- Auditoría, consentimiento y procedencia. Cada acceso y cada documento quedan registrados con
AuditEventyProvenance, con gestión del consentimiento del paciente. - Acompañamiento y simulacros. Capacitamos a los equipos técnicos y clínicos y les ayudamos a practicar el plan de contingencia.
Si su institución comparte hoy resultados, informes o referencias por correo electrónico, conversemos. Escríbanos y revisamos juntos por dónde empezar.
Fuentes
- TechCrunch, Microsoft's latest email outage turned into a full blown global cloud crisis, 13/11/2026.
- Al Jazeera, Microsoft hit by global outages: What happened and why?, 13/11/2026.
- CNN, Massive Microsoft outage disrupts businesses, schools and governments around the world, 12/11/2026.
- Security Magazine, Microsoft Outage Could Lead to $7B in Losses, estimación de Anderson Economic Group.
- The Irish Times, Microsoft outage: what happened and what does it say about online services?, 13/11/2026.
- TechCrunch, Microsoft 365 outage drags on, but things are improving, 01/09/2026.
- The Register, Microsoft 365 outage drags on for nearly 10 hours, 23/01/2026.
Boletín de Meddyg
Noticias, novedades de interoperabilidad y salud digital, y lo nuevo de nuestros servicios y productos.